Développer des solutions pour les informations manquantes sur les haplotypes variants (VHI manquant)
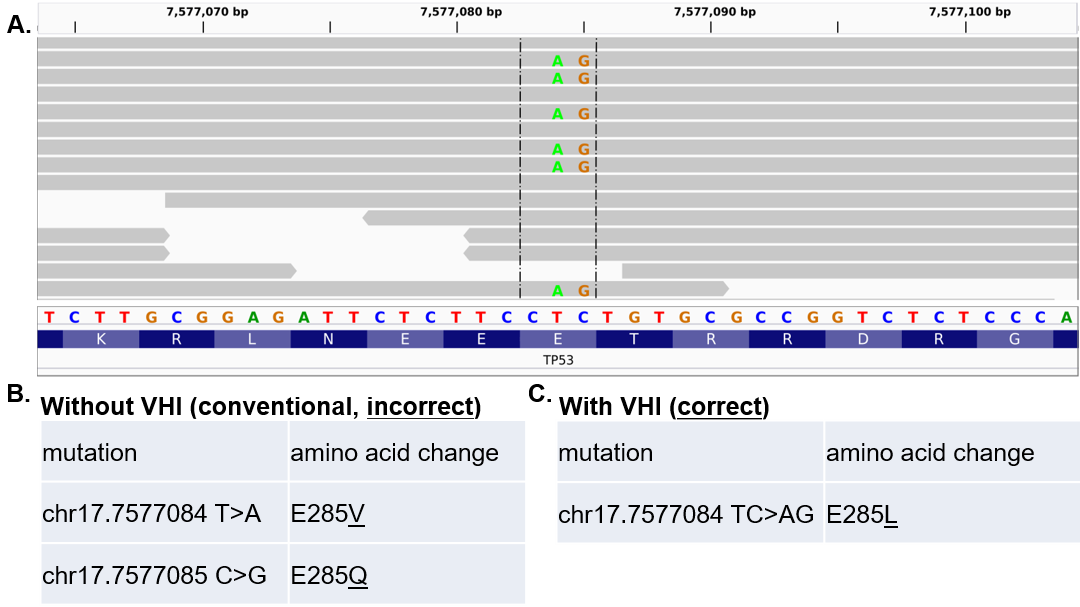
L'absence de VHI est un problème bioinformatique fondamental causé par le fait que les humains ont un génome diploïde, mais la plupart des pipelines bioinformatiques ont été développés sur la base d'une référence humaine contenant un seul ensemble de chromosomes et sans VHI conservé.
Les problèmes résultant de l'absence de VHI, en particulier l'ignorance des variantes proximales sur le même chromosome, peuvent entraîner de nombreux problèmes pour l'annotation et l'interprétation des variantes :
Identifier et corriger les prédictions incorrectes de changement d'acides aminés causées par l'absence de VHI
Nous avons développé un correcteur d'annotation de variantes multinucléotidiques (MAC) :
MAC est le premier logiciel permettant de résoudre un type de problème de VHI manquant. Depuis sa publication, MAC a été cité dans de nombreux articles à fort impact :
- Wang Q, et al. Commun. Nat. 2020 mai 27;11(1):2539
- Łuksza M, et al. La nature. 2017 23 novembre;551(7681):517-520
- Riaz N, et al. Cell. 2017 Nov 2;171(4):934-949.e16
Collaborations
- Nous collaborons avec le Dr Martin Morgan de Roswell Park pour développer des algorithmes bioinformatiques permettant de résoudre de nombreux types d'erreurs systématiques introduites par l'absence de VHI dans les prédictions informatiques.
- Nous collaborons avec Dr Ailong Ke à l'Université Cornell pour développer des outils de calcul à la demande pour l'édition du génome basée sur CRISPR-Cas, y compris l'identification de la cible thérapeutique et la quantification du risque d'effet hors cible en fonction des différences de séquence.
Définition d'un statut négatif pour la comparaison de plusieurs échantillons à l'aide du séquençage de nouvelle génération
Les mutations somatiques liées au cancer peuvent être mesurées à l'aide du séquençage de nouvelle génération (NGS). Pour une mutation spécifique dans un échantillon donné, un test NGS peut donner trois statuts possibles : positif, négatif ou inconnu, principalement en raison d'une faible couverture.
Une solution courante consiste à exiger que la couverture au niveau du site d'une mutation passe par une couverture minimale universelle (UMC). Cependant, cette méthode repose sur un seuil choisi arbitrairement et ne prend pas en compte l'abondance relative des mutations.
Nous proposons une méthode adaptative spécifique aux mutations négatives (MSN) pour améliorer la classification des statuts de mutation négatifs et inconnus dans la comparaison de plusieurs échantillons de tumeurs « apparentées » du même patient.
Nous avons évalué les performances de MSN en utilisant un véritable ensemble de données de séquençage de cellules uniques à double plate-forme. La méthode MSN a non seulement attribué des statuts négatifs avec une meilleure précision que la méthode UMC conventionnelle, mais, plus important encore, a récupéré davantage de données qui seraient autrement classées comme « inconnues » en utilisant UMC.
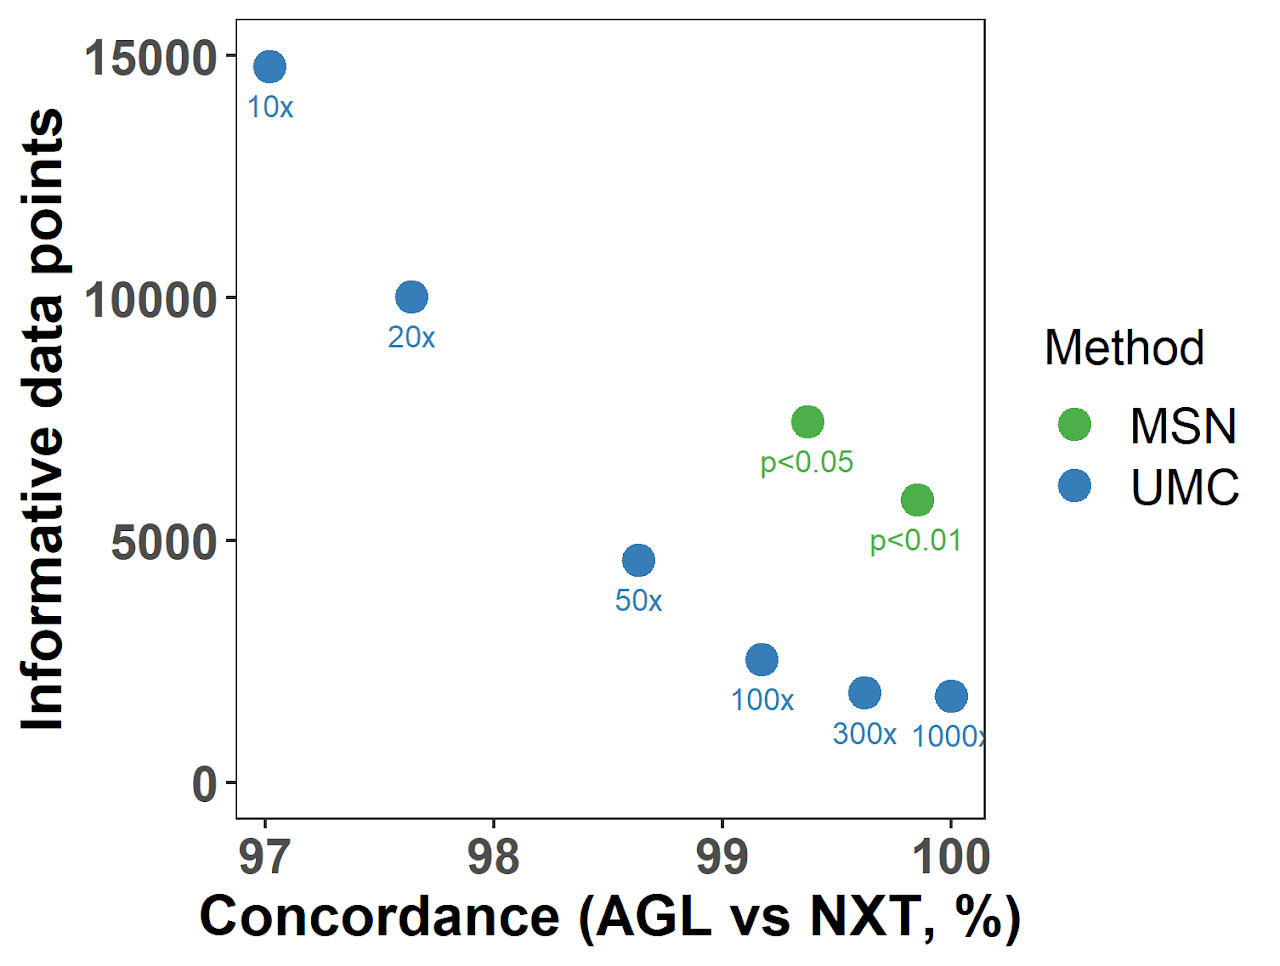
Deux méthodes de définition négative, UMC et MSN, ont été testées dans un ensemble de données de séquençage à double plate-forme à cellule unique en utilisant différents seuils (indiqués sous chaque point). Les performances de chaque exécution ont été évaluées par :
- La concordance des statuts de mutation entre deux séries appariées (Nextera, NXT et Agilent, AGL) de la même cellule unique (axe des X) ; et
- Nombre total de points de données informatifs après exclusion des statuts inconnus (axe Y).
À notre connaissance, MSN est la première méthode dédiée à la définition du statut mutationnel négatif. En plus des analyses d'hétérogénéité tumorale, cette méthode fonctionne également sur d'autres échantillons contenant des cellules tumorales ou de l'ADN tumoral, tels que les cellules tumorales circulantes (CTC) et l'ADN tumoral circulant (ADNct).