Desarrollo de soluciones para la información faltante sobre variantes y haplotipos (VHI faltante)
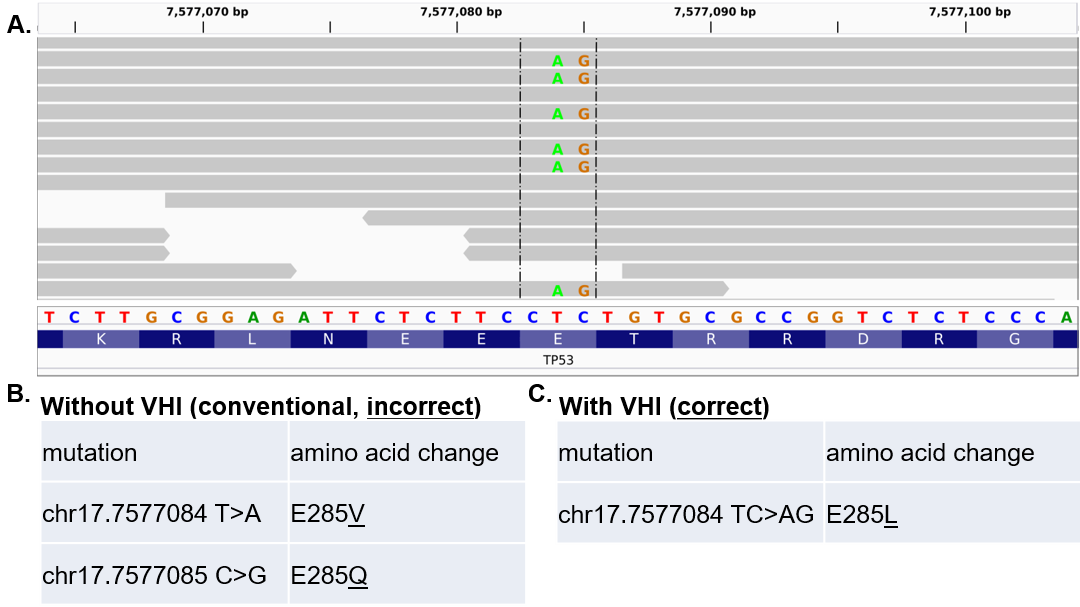
La falta de VHI es un problema bioinformático fundamental causado por el hecho de que los humanos tienen un genoma diploide, pero la mayoría de los procesos bioinformáticos se desarrollaron con base en una referencia humana que contenía solo un conjunto de cromosomas y sin VHI retenido.
Los problemas resultantes de la falta de VHI, especialmente al ignorar las variantes proximales en el mismo cromosoma, pueden causar muchos problemas para la anotación e interpretación de las variantes:
Identificación y corrección de predicciones incorrectas de cambios de aminoácidos causadas por la falta de VHI
Desarrollamos el Corrector de Anotación de Variantes de Múltiples Nucleótidos (MAC):
MAC es el primer software para resolver un tipo de problema de VHI faltante. Desde su publicación, MAC ha sido citado en muchos artículos de alto impacto:
- Wang Q, y col. Comun. Nat. 2020 de mayo de 27;11(1):2539
- Łuksza M, et al. Naturaleza. 2017 de noviembre de 23; 551 (7681): 517-520
- Riaz N, et al. Cell. 2017 Nov 2;171(4):934-949.e16
Colaboraciones
- Estamos colaborando con el Dr. Martin Morgan de Roswell Park para desarrollar algoritmos bioinformáticos para resolver muchos tipos de errores sistemáticos introducidos por la falta de VHI en las predicciones computacionales.
- Estamos colaborando con el Doctor Ailong Ke en la Universidad de Cornell para desarrollar herramientas computacionales a pedido para la edición del genoma basada en CRISPR-Cas, incluida la identificación de objetivos terapéuticos y la cuantificación del riesgo de efectos fuera del objetivo en función de las diferencias de secuencia.
Definición del estado negativo para la comparación de múltiples muestras mediante secuenciación de próxima generación
Las mutaciones somáticas relacionadas con el cáncer se pueden medir mediante secuenciación de nueva generación (NGS). Para una mutación específica en una muestra dada, una prueba NGS puede arrojar tres estados posibles: positivo, negativo o desconocido, principalmente debido a la baja cobertura.
Una solución habitual es exigir que la cobertura en el sitio de una mutación supere una cobertura mínima universal (UMC). Sin embargo, este método se basa en un umbral elegido arbitrariamente y no tiene en cuenta la abundancia relativa de las mutaciones.
Proponemos un método adaptativo de mutación específica negativa (MSN) para mejorar la clasificación de estados de mutación negativos y desconocidos en la comparación de múltiples muestras de tumores "relacionados" del mismo paciente.
Evaluamos el desempeño de MSN utilizando un conjunto de datos de secuenciación de células individuales de plataforma dual real; el método MSN no solo asignó estados negativos con mejor precisión que el método UMC convencional, sino que, lo que es más importante, rescató más datos que de otro modo se clasificarían como "desconocidos" utilizando UMC.
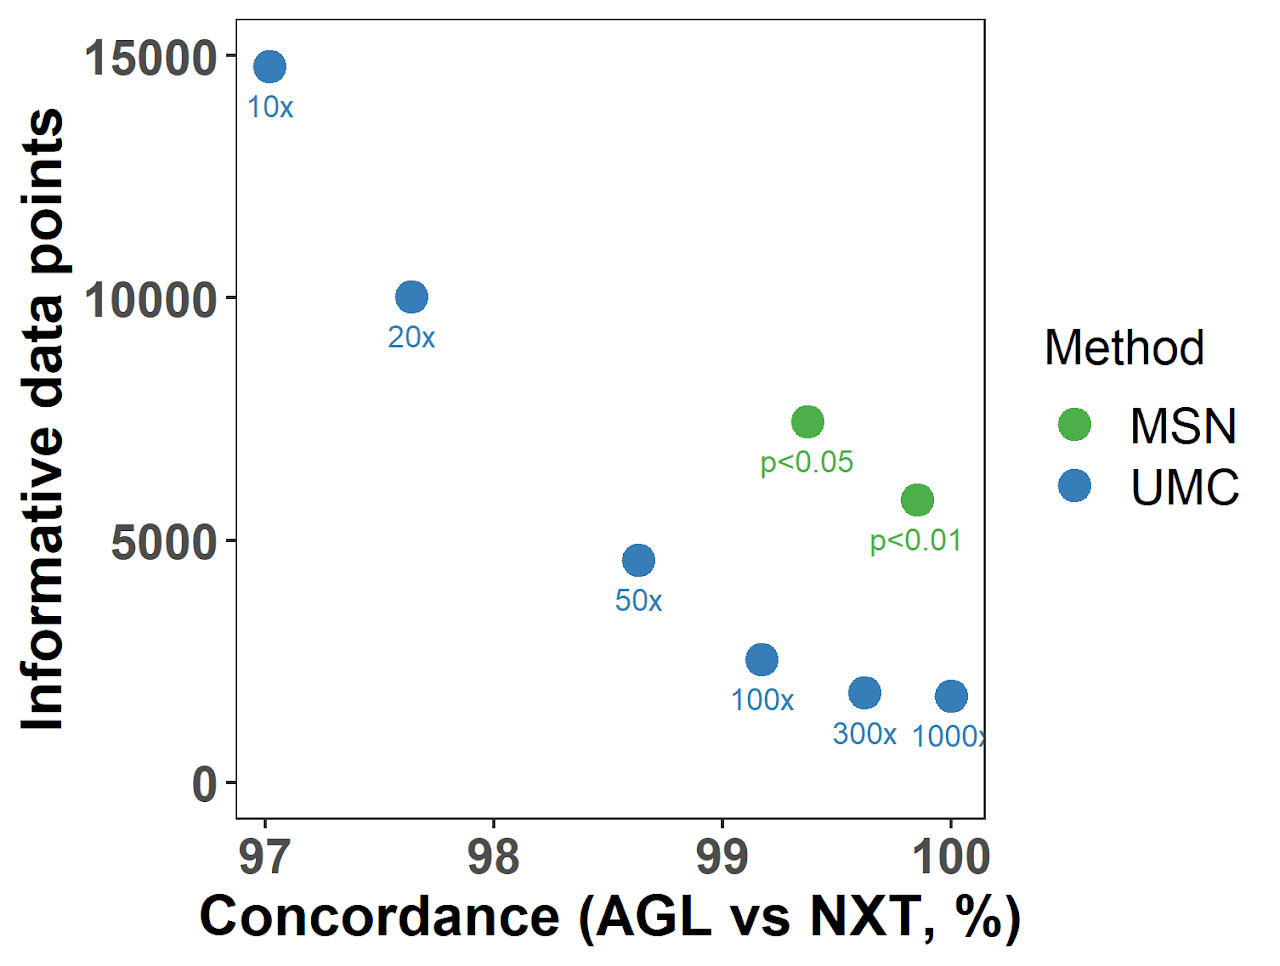
Se probaron dos métodos de definición negativa, UMC y MSN, en un conjunto de datos de secuenciación de plataforma dual de una sola célula utilizando umbrales variables (indicados debajo de cada punto). El rendimiento de cada ejecución se evaluó mediante:
- La concordancia de los estados de mutación entre dos ejecuciones pareadas (Nextera, NXT y Agilent, AGL) de la misma célula individual (eje X); y
- El número total de puntos de datos informativos después de excluir los estados desconocidos (eje Y).
Hasta donde sabemos, MSN es el primer método dedicado a definir el estado mutacional negativo. Además de los análisis de heterogeneidad tumoral, este método también funciona en otras muestras que contienen células tumorales o ADN tumoral, como células tumorales circulantes (CTC) y ADN tumoral circulante (ctDNA).